

场景:可视化大屏编辑器。用户(往往是不太懂前端的运营/数据同学)要把自己业务系统的接口数据接到一个图表组件上。 传统做法是让用户手填 URL、Method、Header、Params、Body……一堆表单,填错一个字段就调不通,体验极差。本文介绍我们是怎么把这件事变成"从浏览器/Postman 复制一段 curl 命令,粘贴进来,一键填充,再写几行 JS 过滤一下数据"的完整链路的。涉及三块:curl 解析器、Monaco 数据过滤器、后端代理解决跨域。
一、整体链路
先看数据从"用户粘贴"到"图表渲染"的完整流转:
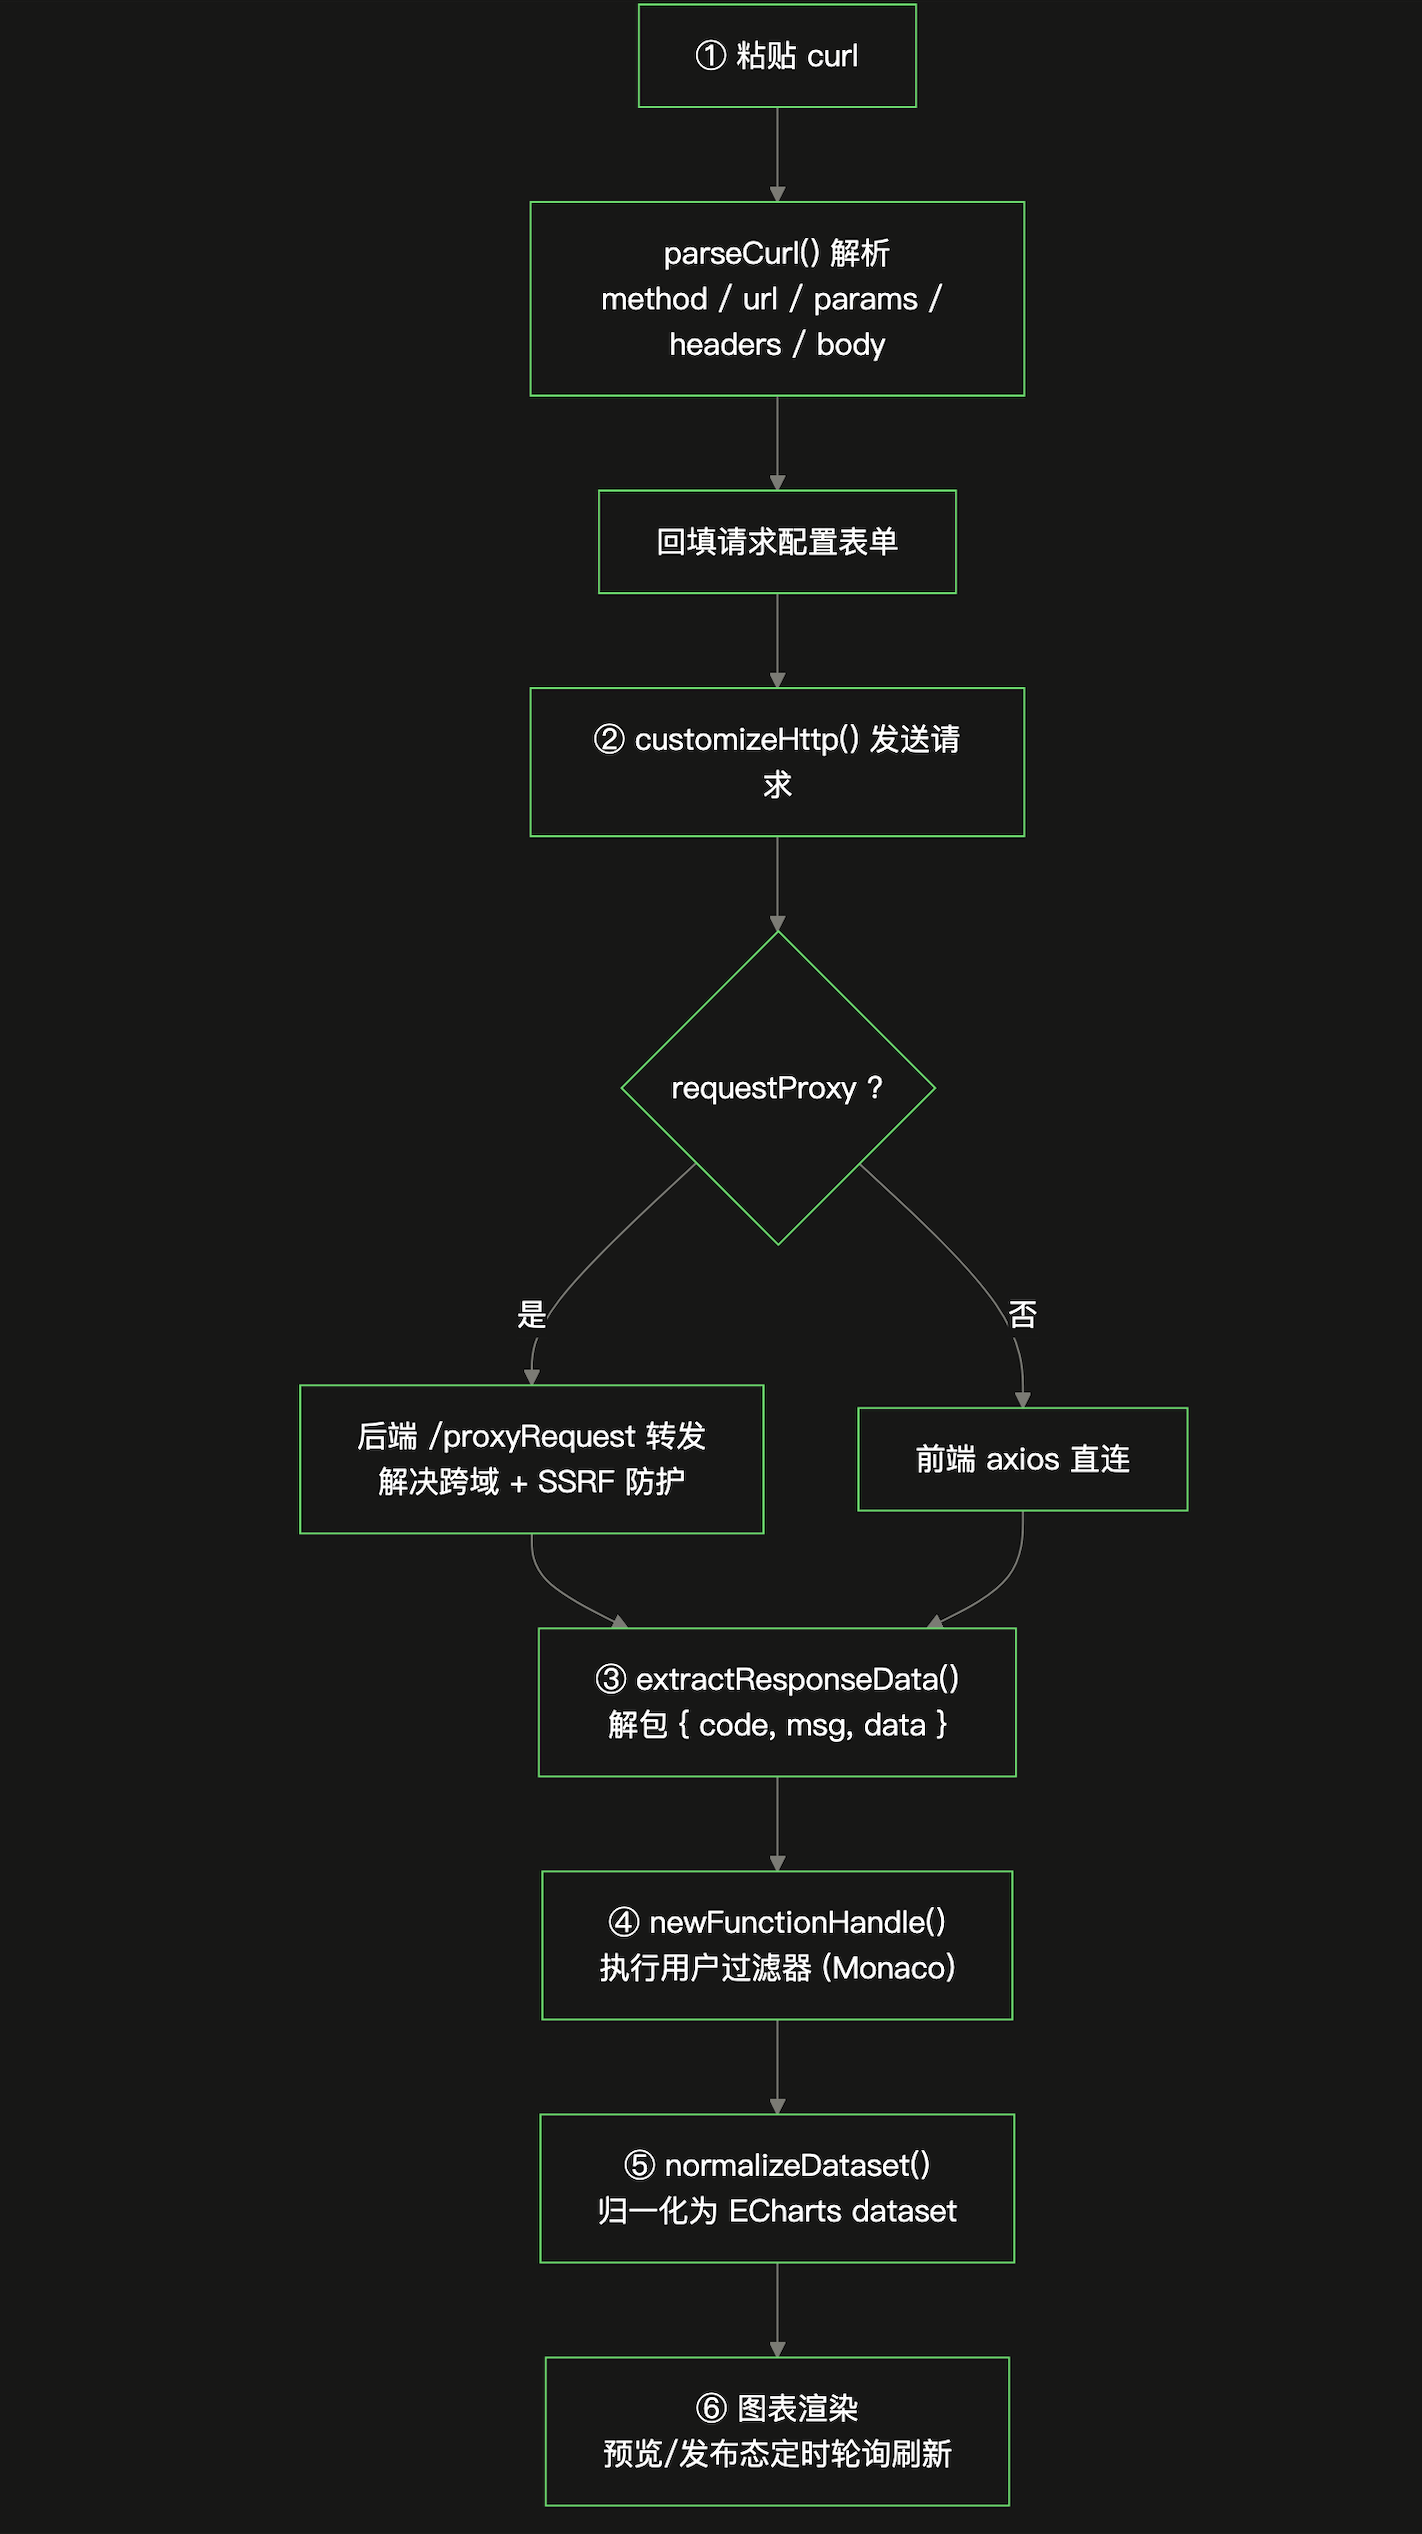
下面拆开讲最有技术含量的三块。
二、curl 解析器:把命令行翻译成请求配置
2.1 为什么要做这个
用户在浏览器 Network 面板里对着一个请求右键 → Copy as cURL,就能拿到一条完整的命令,里面包含了 URL、Method、Header、Body 所有信息。与其让用户把这些信息一项项拆出来填表单,不如让他直接粘进来,我们帮他解析。这就是"零代码"接入的入口体验。
解析目标结构:
{ method, url, params, headers, bodyType, body, error? }2.2 第一步:分词(tokenize)——处理引号和续行
curl 命令最难的地方是引号嵌套和行尾 `\` 续行。不能简单 `split(' ')`,否则 `'{"name":"test"}'` 这种带空格的 Body 会被拆碎。
我们写了一个状态机分词器:
/**
 * 将 curl 命令拆分为 token 数组
 * 支持单引号、双引号包裹的参数,行尾 \ 续行
 */
const tokenize = (command) => {
  const tokens = [];
  let current = "";
  let quote = null;
  // 先把行尾 \ 续行合并成一行
  const text = String(command || "").replace(/\\\r?\n/g, " ");
  for (let i = 0; i < text.length; i++) {
    const ch = text[i];
    if (quote) {
      // 在引号内:遇到匹配的引号才结束,其余字符(含空格)都算内容
      if (ch === quote) {
        quote = null;
      } else {
        current += ch;
      }
    } else if (ch === "\"" || ch === "'") {
      quote = ch; // 进入引号
    } else if (/\s/.test(ch)) {
      if (current) { tokens.push(current); current = ""; } // 空白处分词
    } else {
      current += ch;
    }
  }
  if (current) tokens.push(current);
  return tokens;
};
要点:
- 用一个 `quote` 变量记录"当前在哪种引号里",引号内的空格不分词;
- 先把 `\` + 换行替换成空格,把多行命令拉平;
- 逐字符扫描,比正则更好处理嵌套边界。
2.3 第二步:识别各种选项
拿到 token 数组后,遍历识别 curl 的各类选项。这里覆盖了真实世界的绝大多数写法:
const HTTP_METHODS = ["get", "post", "put", "patch", "delete"];
// 携带请求数据的选项(存在即默认 POST)
const DATA_OPTIONS = ["-d", "--data", "--data-ascii", "--data-raw", "--data-binary"];
// 支持 --data=xxx 等号形式的前缀
const DATA_EQ_PREFIXES = ["--data=", "--data-ascii=", "--data-raw=", "--data-binary=", "--data-urlencode="];
遍历时的分支处理:
for (let i = 0; i < filtered.length; i++) {
  const token = filtered[i];
  const next = filtered[i + 1];

  if (token === "-X" || token === "--request") {          // 显式指定方法
    method = (next || "").toLowerCase(); i++;
  } else if (token === "-H" || token === "--header") {     // 请求头
    if (next) {
      const idx = next.indexOf(":");
      if (idx > 0) {
        const headerName = next.slice(0, idx).trim();
        // 过滤浏览器自动管理/禁止设置的头,避免 CORS 预检失败
        if (!isBrowserManagedHeader(headerName)) {
          headers[headerName] = next.slice(idx + 1).trim();
        }
      }
      i++;
    }
  } else if (token === "-F" || token === "--form") {       // form-data
    if (next) { Object.assign(formFields, parseKeyValueString(next.replace(/;/g, "&"))); i++; }
  } else if (token === "--data-urlencode") {               // urlencoded
    if (next) { Object.assign(urlencodeFields, parseKeyValueString(next)); i++; }
  } else if (DATA_OPTIONS.includes(token)) {               // -d / --data*
    if (next) { dataChunks.push(next); i++; }
  } else if (DATA_EQ_PREFIXES.some((p) => token.startsWith(p))) {  // --data=xxx 等号形式
    const value = token.slice(token.indexOf("=") + 1);
    if (token.startsWith("--data-urlencode=")) Object.assign(urlencodeFields, parseKeyValueString(value));
    else dataChunks.push(value);
  } else if (token === "-G" || token === "--get") {        // 强制 GET,data 转 query
    hasGetFlag = true;
  } else if (token === "--url") {                          // --url 显式地址
    url = next || ""; i++;
  } else if (/^https?:\/\//i.test(token)) {                // 裸 URL
    url = token;
  }
}
2.4 两个关键的"细节正确性"
细节一:过滤浏览器禁止设置的请求头。
从 Chrome 复制的 curl 会带一堆 `user-agent`、`cookie`、`origin`、`referer`、`accept-encoding`、`sec-*` 等请求头。这些头在浏览器 XHR/fetch 里要么被禁止设置,要么被浏览器自动管理。如果原样回填,不仅无意义,还会导致 CORS 预检(preflight)失败。所以解析时直接过滤掉:
const BROWSER_MANAGED_HEADERS = [
  "accept", "accept-encoding", "accept-language", "cache-control", "connection",
  "content-length", "cookie", "date", "host", "origin", "referer",
  "user-agent", "sec-*" /* 等 30 余项 */
];

const isBrowserManagedHeader = (key) => {
  const lower = String(key || "").toLowerCase().trim();
  if (lower.startsWith("sec-")) return true; // sec-fetch-* 等一律过滤
  return BROWSER_MANAGED_HEADERS.includes(lower);
};
细节二:请求方法的推断优先级。
curl 的方法推断有一套约定,我们严格还原:
if (!method) {
  if (hasGetFlag) {
    method = "get";
  } else {
    const hasData = dataChunks.length > 0 ||
      Object.keys(formFields).length > 0 ||
      Object.keys(urlencodeFields).length > 0;
    method = hasData ? "post" : "get";
  }
}
if (!HTTP_METHODS.includes(method)) method = "get";
2.5 Body 类型判定:跟着 Content-Type 走
curl 的 `-d` 数据到底是什么类型?取决于 `Content-Type` 头。我们据此把 Body 归类,并且没有 Content-Type 时遵循 curl 默认行为(按 `x-www-form-urlencoded` 处理):
if (Object.keys(formFields).length > 0) {
  bodyType = RequestBodyEnum.FORM_DATA;  body = formFields;               // -F 表单
} else if (Object.keys(urlencodeFields).length > 0) {
  bodyType = RequestBodyEnum.X_WWW_FORM_URLENCODED; body = urlencodeFields;
} else if (dataChunks.length > 0 && !hasGetFlag) {
  const rawData = dataChunks.join("&");
  if (contentTypeValue.includes("application/json")) {
    bodyType = RequestBodyEnum.JSON; body = formatJson(rawData);          // 顺便美化 JSON
  } else if (contentTypeValue.includes("application/xml")) {
    bodyType = RequestBodyEnum.XML; body = rawData;
  } else if (contentTypeValue.includes("text/plain")) {
    bodyType = RequestBodyEnum.TEXT; body = rawData;
  } else {
    bodyType = RequestBodyEnum.X_WWW_FORM_URLENCODED;                     // curl 默认
    body = parseKeyValueString(rawData);
  }
}
另外 URL 里的 query 会被拆出来单独放进 `params`(`url.split("?")`),`-G` 模式下 `-d` 数据也会转成 query 参数——完全对齐 curl 语义。
2.6 UI:解析 → 预览 → 确认填充
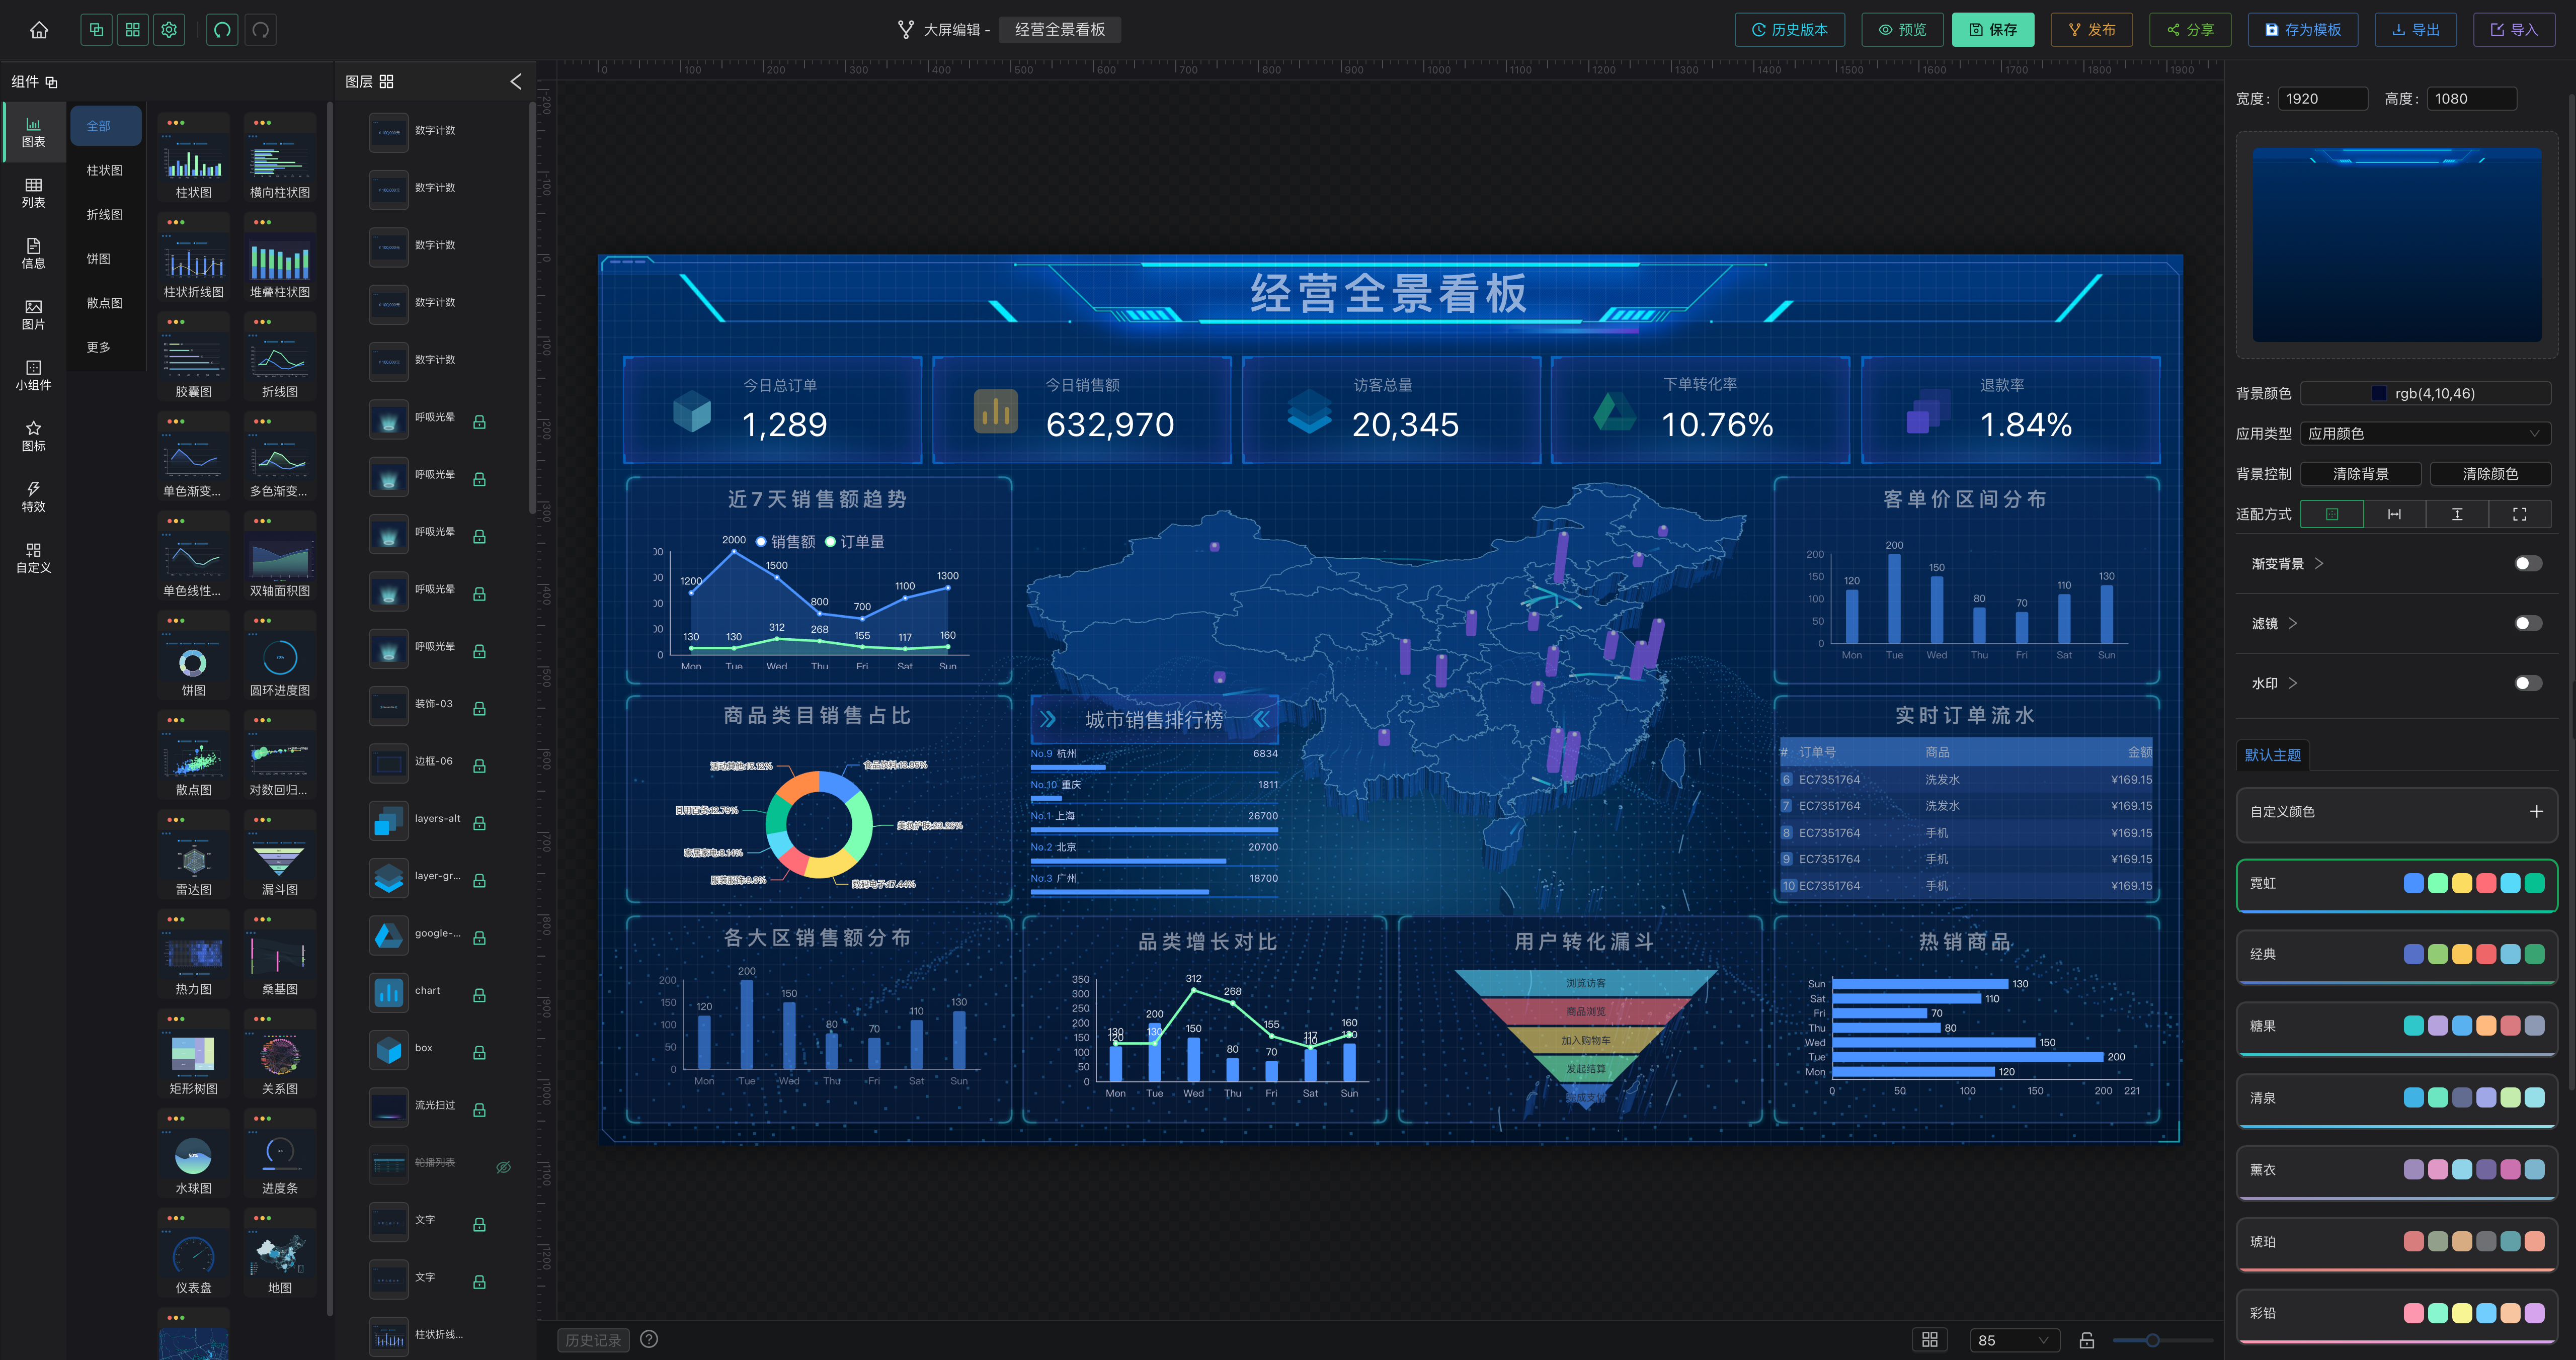
解析器是纯函数,UI 层(`ParseCurlModal`)做成"粘贴 → 解析 → 可视化预览 → 确认填充"三步。预览用表格展示 Params/Header、用 `<pre>` 展示 Body,Method 用不同颜色的 Tag,让用户在填充前能确认解析结果对不对:
const handleParse = () => {
  if (!curlText.trim()) { setParseResult({ error: "请先粘贴 curl 命令" }); return; }
  setParseResult(parseCurl(curlText));
};
// 解析失败 → Alert 报错;成功 → 展示 Method/URL/Params/Header/Body 预览
// 用户点"确认填充" → onApply(parseResult) 回传父组件写入请求配置
真实界面如下。粘贴一段 curl 点击"解析"后,方法、地址、Params、Header、Body 会以可视化形式预览,确认无误再一键填充:
三、Monaco 数据过滤器:让用户写几行 JS 把数据"翻译"成图表格式
3.1 为什么需要过滤器
接口返回的数据结构千奇百怪,但 ECharts 图表要的是特定的 `dataset` 结构。中间这段"字段重命名、数值计算、筛选、排序、结构转换"的活儿,不可能用表单配置穷举,只能让用户写代码。
于是我们内嵌了一个 Monaco Editor(就是 VS Code 的编辑器内核),让用户在弹窗里写一个过滤函数:
function filter(data, res) {
  // data:接口返回值(默认已解包 data 字段)
  // res:完整响应对象
  // return:符合组件数据结构的数据
  return data.list.map(item => [item.name, item.value]);
}
3.2 过滤器的执行:`new Function` + 深拷贝隔离
用户写的是一段字符串,怎么执行?用 `new Function` 动态构造。这里有个安全性 + 稳定性的关键设计——传入深拷贝,防止用户的过滤函数意外改到原始数据:
export const newFunctionHandle = (data, res, funcStr) => {
  try {
    if (!funcStr) return data;                       // 没写过滤器,原样返回
    const fn = new Function("data", "res", funcStr);
    // 深拷贝隔离:用户在 filter 里怎么折腾都不影响原始 data / res
    const fnRes = fn(JSON.parse(JSON.stringify(data)), JSON.parse(JSON.stringify(res)));
    return fnRes;
  } catch (error) {
    console.error("过滤器执行失败:", error);
    return data;                                     // 出错兜底:返回原数据,不崩图表
  }
};
两个细节:
深拷贝隔离:`JSON.parse(JSON.stringify(...))` 传副本进去,用户就算写了 `data.sort()`(原地修改)也污染不到源数据;
try/catch 兜底:过滤函数抛错时返回原始 `data`,保证图表至少还能渲染,而不是白屏。
3.3 编辑体验:实时预览 + 示例数据 + 语法校验
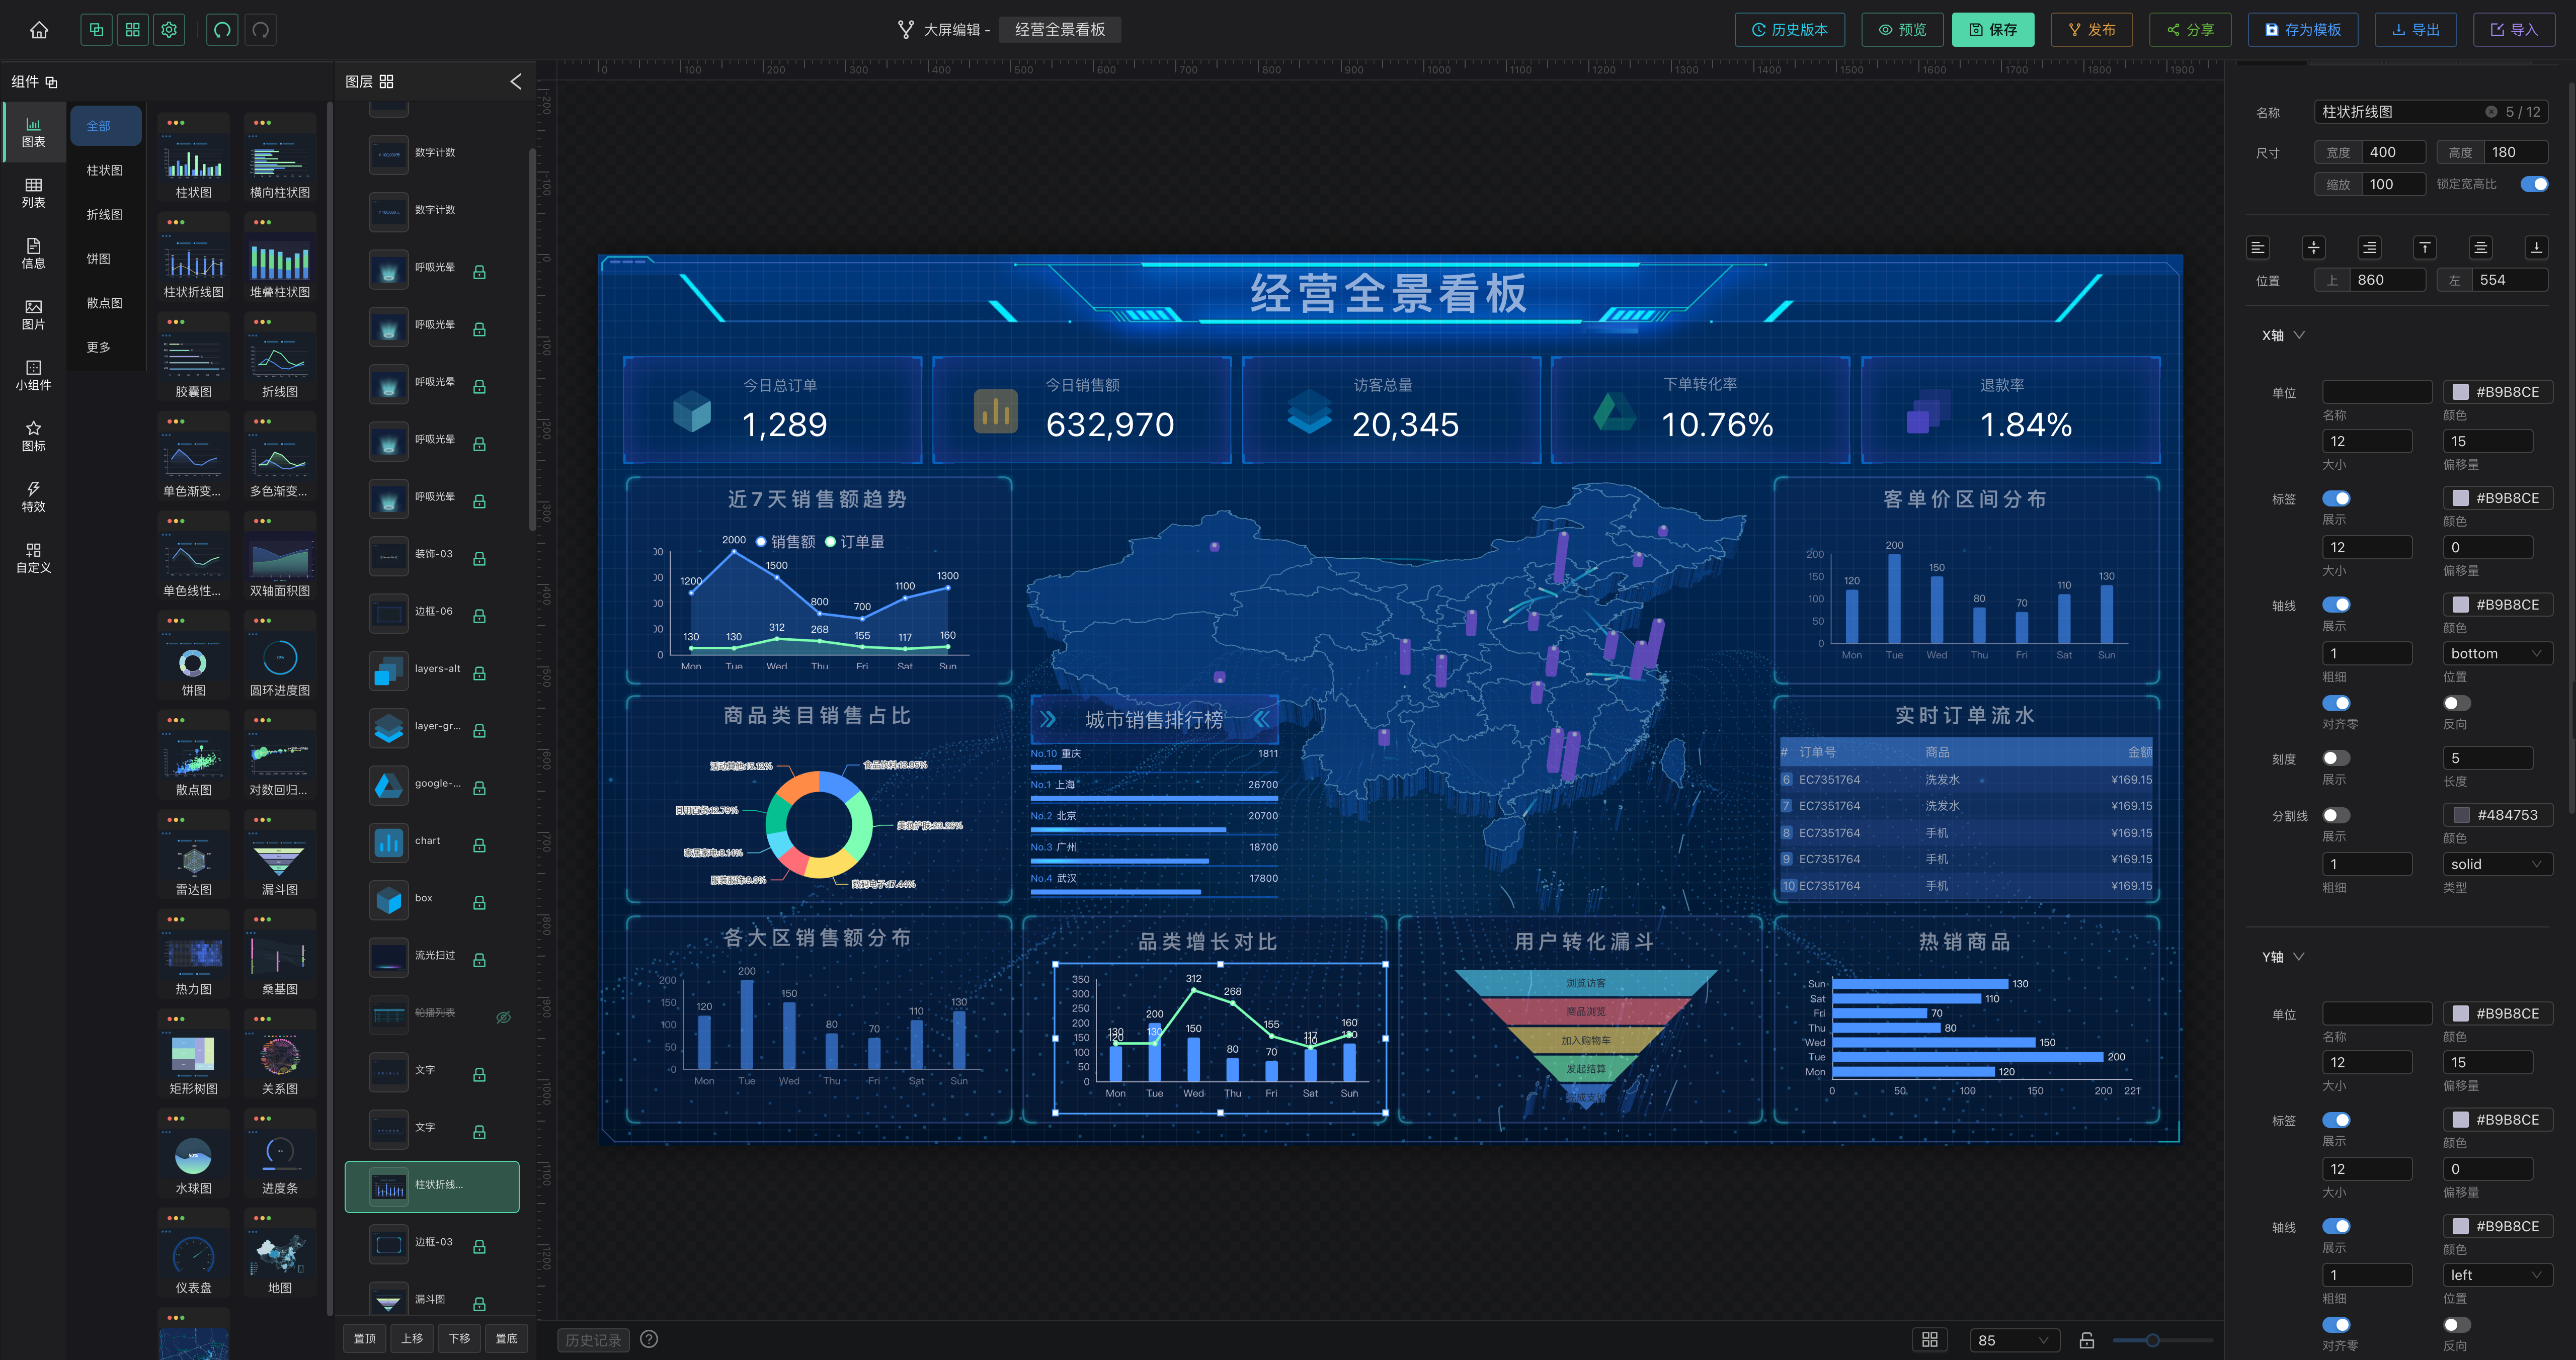
`DataFilter` 组件把编辑体验做得很完整。左边是 Monaco 编辑器,右边实时预览"输入数据"和"过滤结果",用户一边写一边看结果对不对:
// 实时预览:过滤函数每次变化都重新执行,结果实时展示
const filterResult = useMemo(() => {
  try {
    const result = newFunctionHandle(previewData, { data: previewData }, filterValue);
    setHasError(false);
    return typeof result === "string" ? result : JSON.stringify(result, null, 2);
  } catch (error) {
    setHasError(true); // 有错时禁用"保存"按钮
    return `过滤函数错误: ${error.message}`;
  }
}, [filterValue, previewData]);
<MonacoEditor
height="360px" width="440px"
language="javascript"
value={filterValue}
onChange={(v) => setFilterValue(v || DEFAULT_FILTER)}
theme="vs-dark"
options={{
minimap: { enabled: false },
fontSize: 14,
lineNumbers: "on",
automaticLayout: true,
tabSize: 2,
wordWrap: "on"
}}
/>真实界面如下,左侧 Monaco 编辑器写过滤函数,右侧实时预览"输入数据"和"过滤结果":
体验细节:
预览输入优先用真实响应:`previewData = sourceData ?? component.option.dataset`,用户点过"发送请求"后就用真实数据预览,更贴近实际;
"示例数据"弹窗:展示当前组件静态数据的 dataset 结构,告诉用户"你的 return 应该长这样",降低理解成本;
语法错误时禁用保存:`hasError` 为 true 时保存按钮 disabled,不让错误的过滤器流到线上;
`automaticLayout: true`:弹窗尺寸变化时编辑器自适应,避免 Monaco 在 Modal 里常见的布局塌陷问题。
3.4 过滤器 + 归一化的双段串联
过滤器解决"业务转换",但用户可能还是不返回标准结构。所以过滤器后面永远再串一层 `normalizeDataset` 做"格式兜底":
// 1. 解包:{ code, msg, data } 结构取内层 data
const data = extractResponseData(res.data);
// 2. 过滤器(业务转换)
const filteredData = newFunctionHandle(data, res, comp.filter);
// 3. 归一化(格式兜底),始终串联
const dataset = normalizeDataset(filteredData);
// 解包 { code, msg, data } 的 data 字段
export const extractResponseData = (body) => {
if (body && typeof body === "object" && !Array.isArray(body) && "data" in body) {
return body.data;
}
return body;
};
// 归一化:null → 空 dataset;已合法 → 直接返回;字符串 → 尝试 JSON.parse;数字字符串 → 转数字
export const normalizeDataset = (raw) => {
if (raw == null) return { source: [] };
if (isValidEchartsDataset(raw)) {
return Array.isArray(raw) ? { source: raw } : raw;
}
// ...兜底转换
};设计原则很清晰:过滤器负责"业务语义"(用户最懂自己的数据),归一化负责"格式合法"(框架兜底),两段各司其职,串联执行。当两者都无法产出有效数据时,才提示用户"请编写过滤器"。
四、后端代理:解决跨域,同时防住 SSRF
4.1 跨域问题
用户接的第三方接口,绝大多数不支持 CORS。前端 axios 直连必然被浏览器跨域策略拦截。解决方案是后端代理转发:前端把请求参数发给自己的后端,后端用 `node-fetch` 去请求目标接口,再把结果透传回来。
前端通过一个 `requestProxy` 开关决定走不走代理(`src/api/http.js`):
// 开启服务端代理时,走后端 /proxyRequest 转发,解决跨域问题
if (requestProxy) {
  const proxyRes = await HttpUtil.post(HttpApi.proxyRequest, {
    requestUrl: fullUrl,
    requestHttpType: requestHttpType || RequestHttpEnum.GET,
    headers, params, body: rawBody, bodyType
  }, { isHandleResult: true, isShowLoading: false });

  if (proxyRes && proxyRes.code === 200 && proxyRes.data) {
    // 转换为 axios 风格的响应结构,保持下游逻辑兼容
    return { data: proxyRes.data.body, status: proxyRes.data.status };
  }
  throw new Error(proxyRes?.msg || "代理请求失败");
}
// 未开代理 → 前端直连
return await axiosInstance({ url: fullUrl, method, data, params, headers });
一个巧妙点:代理返回结果被包装成 axios 风格的 `{ data, status }`,这样无论走不走代理,下游的解包/过滤/归一化逻辑完全一致,无需分支处理。
注意 `rawBody`:FormData 无法序列化透传给后端,所以代理模式下额外维护一份可序列化的 `rawBody`,form-data 走代理时降级为 `x-www-form-urlencoded` 传输(不支持文件上传)。
4.2 代理必须防 SSRF
一旦开了后端代理,就等于给了前端一个"让服务器替我请求任意地址"的能力。如果不加限制,攻击者可以让服务器去请求 `http://169.254.169.254`(云厂商元数据)、`http://127.0.0.1:xxxx`(内网服务)——这就是经典的 SSRF(服务端请求伪造)。
后端代理控制器(`screen_server_clickhouse/controllers/screenProxy.js`)做了完整防护:
/**
 * 校验目标 URL 是否安全(SSRF 防护)
 * 仅允许 http/https 协议,禁止解析到内网/保留地址
 */
const validateTargetUrl = async (targetUrl) => {
  let urlObj = null;
  try { urlObj = new URL(targetUrl); }
  catch (e) { return { valid: false, msg: '请求地址格式不正确' }; }

  // ① 仅允许 http/https(挡掉 file:// gopher:// 等危险协议)
  if (urlObj.protocol !== 'http:' && urlObj.protocol !== 'https:') {
    return { valid: false, msg: '仅支持 http/https 协议' };
  }

  const hostname = urlObj.hostname;

  // ② hostname 本身是 IP 时直接校验
  if (net.isIP(hostname)) {
    if (ipUtil.isPrivate(hostname) || hostname === '0.0.0.0') {
      return { valid: false, msg: '禁止访问内网地址' };
    }
    return { valid: true, msg: '' };
  }

  // ③ 域名要先解析再校验所有 IP,防止域名指向内网(DNS rebind / 内网域名)
  try {
    const addresses = await dns.promises.lookup(hostname, { all: true });
    for (const addr of addresses) {
      if (ipUtil.isPrivate(addr.address) || addr.address === '0.0.0.0') {
        return { valid: false, msg: '禁止访问内网地址' };
      }
    }
  } catch (e) {
    return { valid: false, msg: '域名解析失败,请检查请求地址' };
  }
  return { valid: true, msg: '' };
};
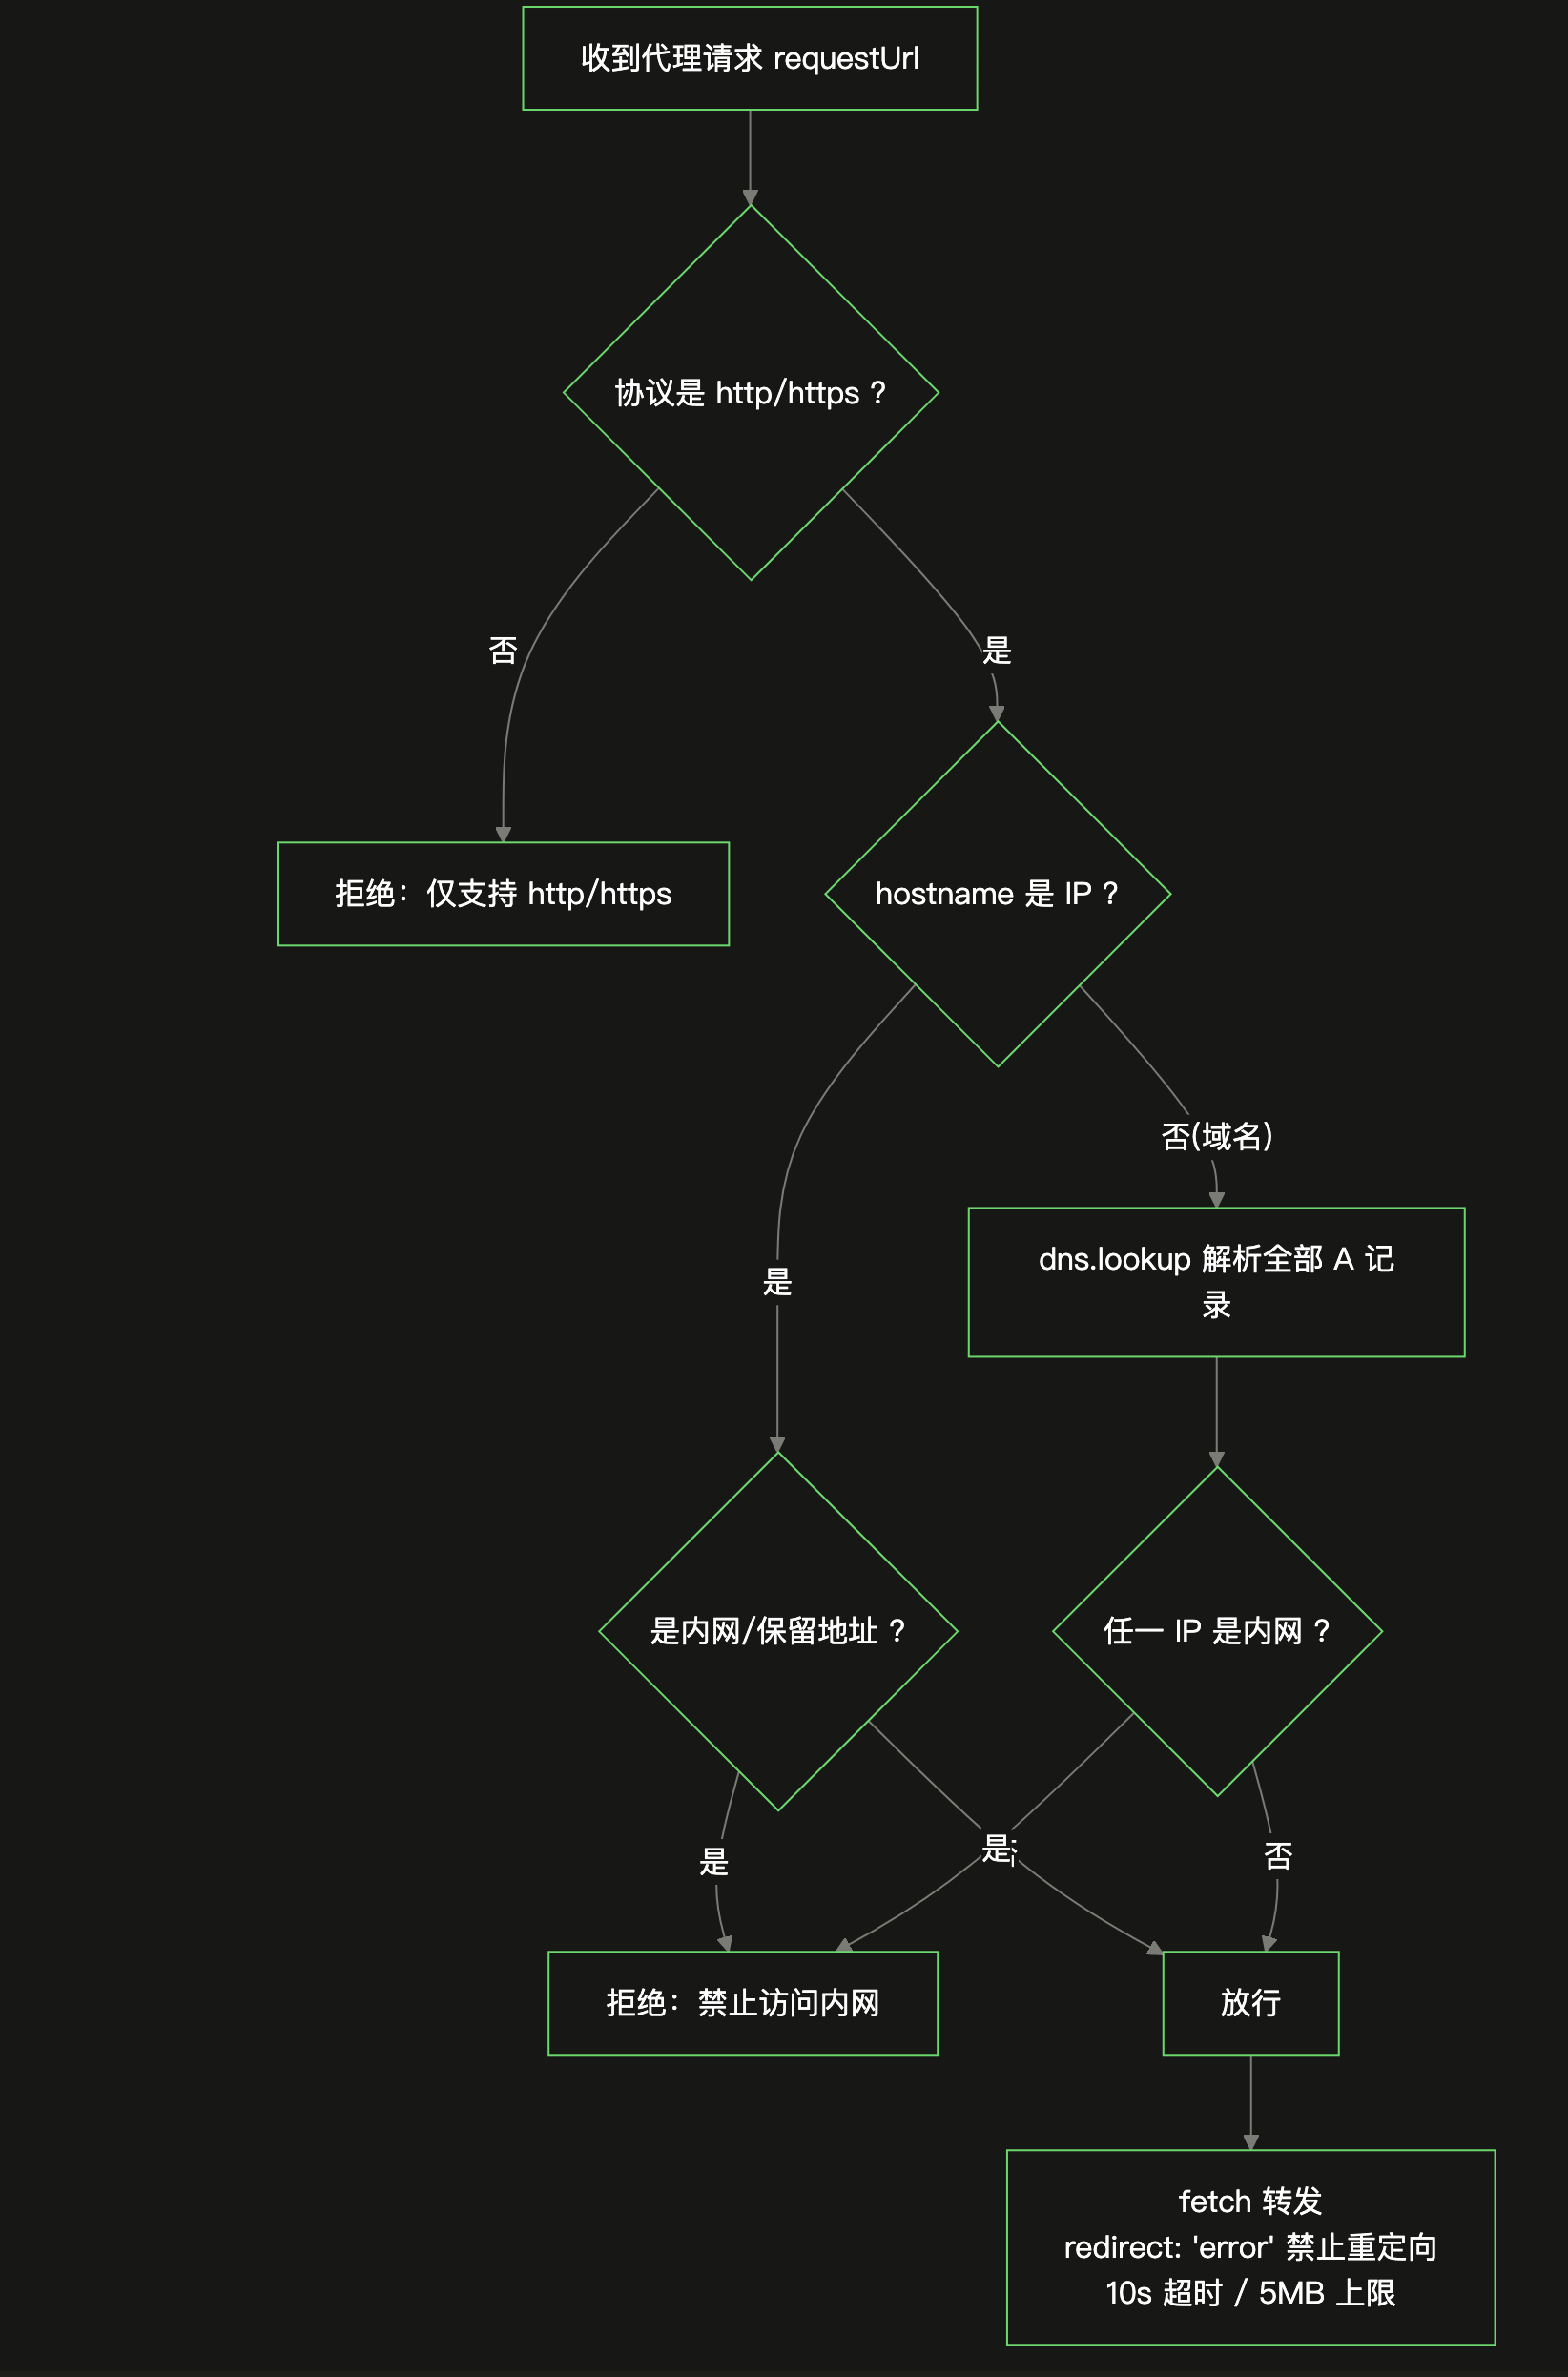
三层防护缺一不可:
1. 协议白名单:只允许 `http/https`,挡掉 `file://`、`gopher://` 等能被利用的危险协议;
2. IP 直连校验:目标是 IP 时,用 `ip.isPrivate()` 判断是否内网/保留地址;
3. 域名解析后校验:⚠️ 最容易被漏掉的一层——域名可能解析到内网 IP(如 `local.attacker.com → 127.0.0.1`)。所以必须 `dns.lookup(..., { all: true })` 拿到全部 A 记录,逐个校验,一个内网就拒绝。
整个校验流程如下:
除此之外还有几道加固:
const PROXY_TIMEOUT = 10000;          // 10s 超时,防止慢接口拖垮服务
const PROXY_MAX_SIZE = 5 * 1024 * 1024; // 5MB 响应体上限,防止大响应打爆内存
const BLOCKED_HEADERS = ['cookie', 'host', 'content-length', 'connection']; // 不透传的敏感头

const fetchOptions = {
  method, headers: filterHeaders(headers),
  timeout: PROXY_TIMEOUT,
  size: PROXY_MAX_SIZE,
  redirect: 'error' // 禁止重定向,防止目标 302 跳转到内网地址绕过校验
};
`redirect: 'error'` 尤其关键:如果不禁止重定向,攻击者可以用一个公网地址 302 跳转到内网,绕过前面的 URL 校验。禁止重定向 + 校验目标IP 才能形成闭环。
请求头也做了过滤,去掉 `cookie`(防止泄露登录态)、`host`、`content-length`、`connection`(防止干扰转发)。
4.3 代理与商业授权的结合
还有一个产品层细节:代理接口在转发前会先校验激活码有效性,无效或到期直接拒绝转发。这样"服务端代理"这个能力也被纳入了商业授权管控。
static async proxyRequest(ctx) {
  // 激活码检查:无效或到期时,禁止代理转发第三方请求
  const purchaseCodeValid = await CommonUtil.checkScreenStatus(ctx);
  if (!purchaseCodeValid) return;
  // ...SSRF 校验 → doProxyRequest → 返回结果
}
五、运行时:变量替换与定时轮询
5.1 全局变量占位符 `{{varName}}`
请求配置里支持 `{{varName}}` 占位符,运行时用全局变量替换。变量来源有两级,URL query 参数优先级高于编辑器配置的默认值:
export const getRuntimeVariables = (defaults = []) => {
  const vars = {};
  // 1. 编辑器配置的默认值
  (defaults || []).forEach((item) => {
    if (item && item.key) vars[item.key] = item.value != null ? String(item.value) : "";
  });
  // 2. URL query 参数覆盖默认值(分享链接可动态传参)
  const searchParams = new URLSearchParams(window.location.search);
  searchParams.forEach((value, key) => { vars[key] = value; });
  return vars;
};

// 递归替换字符串/数组/对象里的 {{key}}
export const replaceVariables = (target, vars) => {
  if (typeof target === "string") {
    return target.replace(VARIABLE_REG, (match, key) =>
      Object.prototype.hasOwnProperty.call(vars, key) ? vars[key] : match);
  }
  if (Array.isArray(target)) return target.map((item) => replaceVariables(item, vars));
  if (typeof target === "object" && target !== null) {
    const result = {};
    for (const key in target) result[key] = replaceVariables(target[key], vars);
    return result;
  }
  return target;
};
这让一块大屏可以通过分享链接的 query 参数动态切换数据(比如 `?deptId=123`),非常实用。此外还支持 `` 前缀的动态表达式和 `${}` 模板字符串 URL,用 `new Function` 求值。
5.2 定时轮询刷新
预览/发布态下,图表需要定时拉最新数据。`useChartDataFetch` 用 `setInterval` 实现,**组件级间隔优先,否则用全局间隔**:
const time = (targetInterval != null && targetInterval > 0) ? targetInterval : globalInterval;
const unit = (targetInterval != null && targetInterval > 0) ? targetUnit : globalUnit;
const ms = intervalUnitHandle(time, unit); // second/minute/hour/day → 毫秒

if (intervalRef.current) clearInterval(intervalRef.current); // 清旧定时器
if (ms > 0) intervalRef.current = setInterval(fetchFn, ms);   // 启新定时器
一个容易踩的坑:轮询回调里要拿到**最新的组件配置**,而不是闭包里捕获的旧值。用 `useRef` 存最新 config 解决:
const componentRef = useRef(component);
componentRef.current = component; // 每次渲染同步最新值
const fetchFn = useCallback(async () => {
  const comp = componentRef.current; // 从 ref 读,避免闭包陷阱
  // ...
}, [onDataChange]);
组件卸载 / 配置变化时清理定时器,避免内存泄漏和重复请求。轮询失败采用**静默告警**(`console.warn`),不弹窗——大屏 7×24 挂着,频繁弹窗是灾难。
六、总结
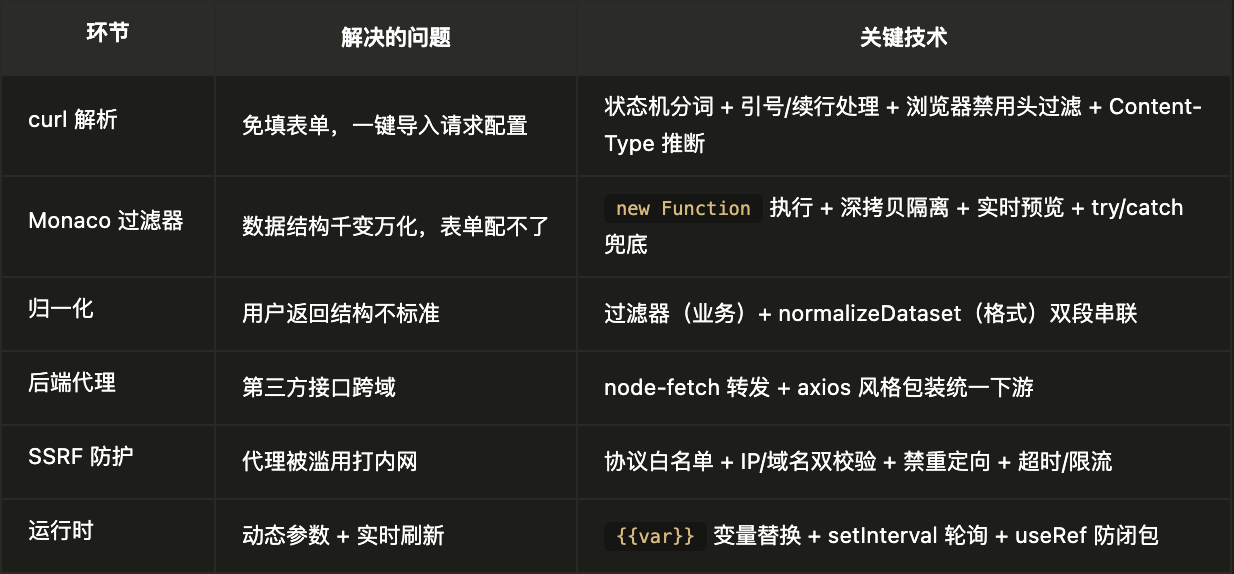
几点体会:
1. "零代码"不等于"没代码",而是把代码藏到用户最舒服的地方——curl 是用户已经会用的东西,过滤器只在需要时才写。
2. 凡是让服务器"代为请求外部地址"的功能,SSRF 防护是底线,尤其是域名解析后校验和禁止重定向这两条,最容易漏。
3. 健壮性靠"层层兜底":解析失败给 error、过滤器出错返原数据、归一化处理 null、轮询失败静默——每一层都不让脏数据/异常搞崩整个图表。
希望这篇能给你做低代码/可视化数据接入时提供一些参考。